
IT之家 11 月 19 日消息,11 月 18 日,地平線機器人實驗室發佈原生視頻幾何基礎模型 LoFT(Looped Foundation Transformer for Video Geometry)。據介紹,該模型能夠從 RGB 視頻中聯合預測相機位姿、內參及逐幀深度,恢復場景三維結構,為機器人空間感知、環境理解與具身學習提供幾何基礎。
官方稱,LoFT 原生面向連續視頻建模,採用雙循環 Transformer 架構,將跨幀視覺信息聚合與相機狀態迭代優化相結合,用於挖掘視頻中的時序關聯與多視角幾何信息。
IT之家從官方公佈信息獲悉,第一循環通過局部與全局時序注意力聚合跨幀信息,逐步擴大時間感受範圍,利用相鄰幀的連續性與跨視角的幾何關聯;第二循環顯式更新相機位姿與內參,並將相機狀態反饋至下一輪特徵計算。
模型結合雙循環特徵預測逐幀深度及其置信度,恢復場景的可見三維結構。
官方表示,為支撐規模化訓練,團隊搭建了統一的三維重建數據處理與訓練平臺,約 297 萬條有效訓練序列、9.62 億幀圖像記錄,覆蓋仿真與真實、動態與靜態等多樣化場景,並通過統一的數據清洗、質量篩選和採樣策略提供數據基礎。
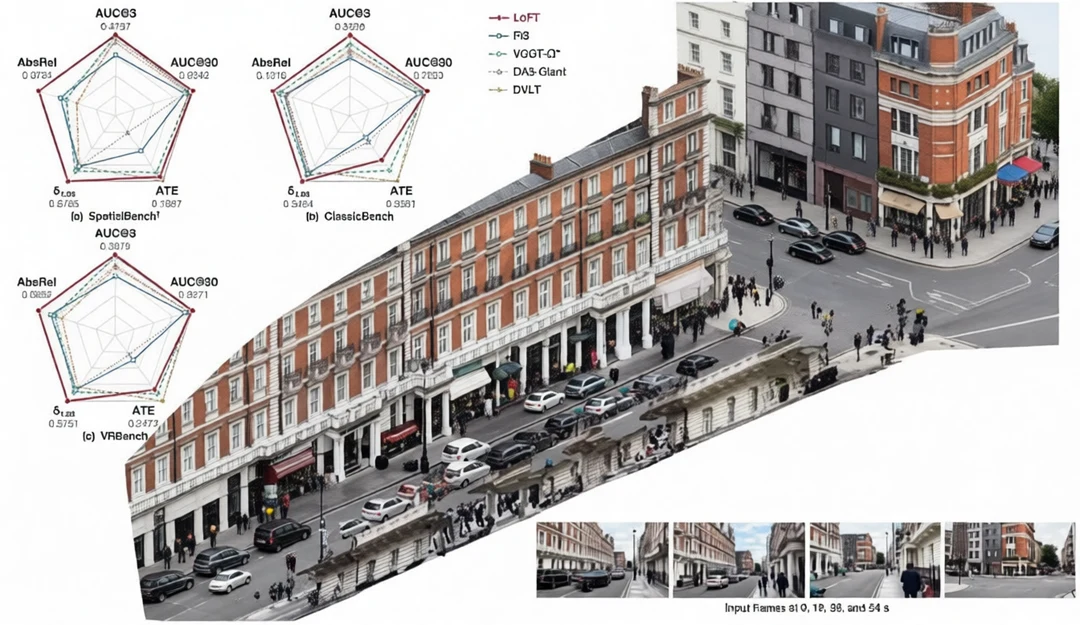
評測方面,研究團隊在 SpatialBench、ClassicBench 和 VRBench 三套評測體系中將 LoFT 與 VGGT-Ω、DA3-Giant 等代表性模型比較。其中 SpatialBench 覆蓋 12 個數據集、98 個連續視頻場景;ClassicBench 整合 7 個經典視頻重建基準;VRBench 涵蓋機器人、自動駕駛及通用視頻場景。據官方公佈信息,LoFT 在多項深度估計指標上達到 SoTA。
在應用側,官方稱 LoFT 可利用連續視頻中的時序與多視角幾何信息,恢復場景三維結構與相機運動軌跡,覆蓋機器人第一人稱視頻、動態街道、室內操作及開放環境探索等場景。
參考
廣告聲明:文內含有的對外跳轉鏈接(包括不限於超鏈接、二維碼、口令等形式),用於傳遞更多信息,節省甄選時間,結果僅供參考,IT之家包含外鏈的文章均包含本聲明。
來源:IT之家