
當地時間11月10日,Google DeepMind正式發佈新一代視覺-語言-動作(VLA)模型Gemini Robotics 2.5,在其公佈的實驗評測數據裡,該模型在靈巧操作表現非常“亮眼”,谷歌稱其“正令人期待地接近人類水平”。
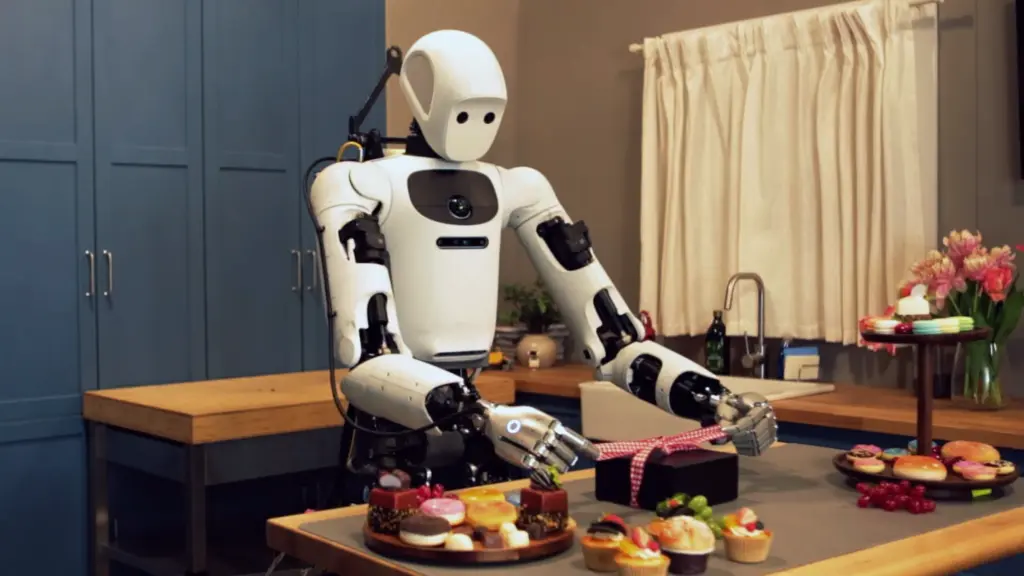
在針對約200項不同任務評測中,該模型在需要高度靈巧性的任務上表現明顯改善,比如用夾子裝取糕點的任務,成功率從5%提升至100%;絲帶等可變形物體一直很難被機器人操控,該模型解開絲帶蝴蝶結的成功率從0%提升至70%;懸掛開衫的成功率從0%提升至62%;摺疊褲子的成功率則從0%提升至40%。在任務精度、魯棒性和速度顯著提升。
與之前的版本相比,Gemini Robotics 2.5任務完成速度提高了20%-30%。此外,在多步驟和接觸密集型任務中,Gemini Robotics 2.5的表現有了明顯提升。
Gemini Robotics 2.5 可以解開蝴蝶結 來源:Google DeepMind官網
Google DeepMind透露,Gemini Robotics 2.5之所以能在短時間內取得快速迭代,很大程度上得益於2026年10月發佈的Gemini 4 Argon模型,Argon構建了一套“仿真引擎”,大幅加快了Gemini Robotics 2.5的研發。
Google DeepMind 機器人研究科學家諾曼·迪·帕洛(Norman Di Palo)在社交平臺上進一步介紹,“這是我們的全新基礎模型,也是首個通過Gemini4 Argon實現加速的模型”,他也同時提到,“我們正在推進遞歸自我改進(RSI)這件事,而在機器人領域,這已經開始顯現成效。”
除了桌面和日常家務操作,谷歌還將測試延伸至汽車工業生產現場。
官方透露,團隊與美國機器人公司Apptronik,在梅賽德斯—奔馳匈牙利和德國的汽車生產線上開展概念驗證。
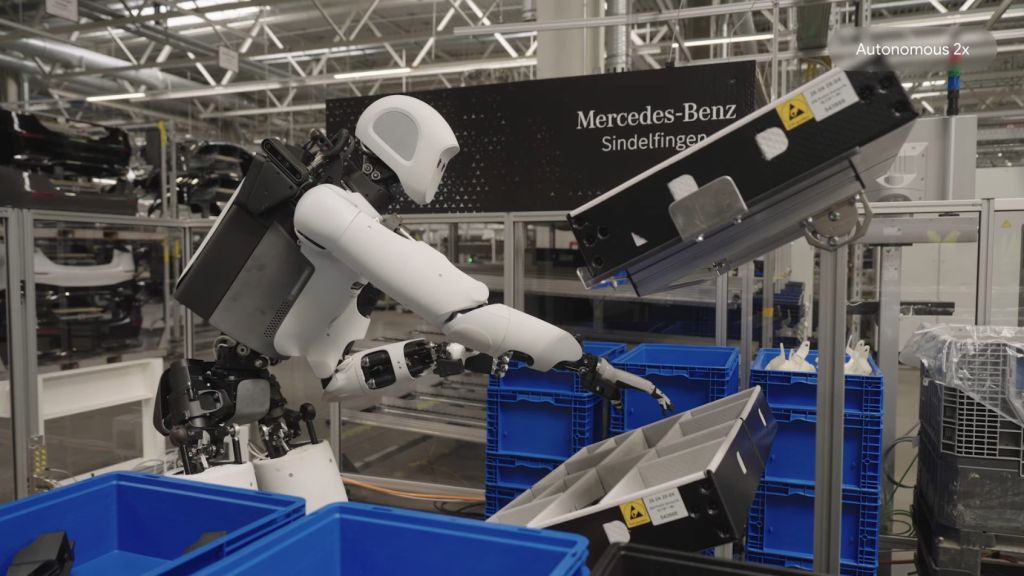
搭載了該模型的人形機器人在汽車產線上完成工作 來源:Google DeepMind官網
阿波羅2號人形機器人搭載著該模型,從料箱中取出汽車金屬支架,再按生產所需順序放入容器,這一任務的成功率為96%。DeepMind總監卡尼什卡·拉奧(Kanishka Rao)在接受外媒採訪時直言,彌合最後這4%的差距,將是一條“艱難的道路”。
來源:澎湃新聞